零结果率的成本落在询盘上
零售站的搜索失败丢的是一单。B2B 独立站丢的是一个还没进 CRM 的名字,而且这个人不会回来告诉你他搜过。他关掉页面,去问了 ChatGPT。
更麻烦的地方在于,搜索日志里那条失败的查询,是全年最贵的一条数据。它写的正是客户的原话。
五个公开项目的实测变化
下表把能查到的公开结果放在一起,覆盖零售、外卖平台、多品类电商三类场景。各家口径不一样,看趋势,不看小数点。
| 项目 | 场景 | 改造方式 | 公开的效果 |
|---|---|---|---|
| PrettyLittleThing | 服饰零售 | 语义理解型搜索 | 零结果搜索下降 97%,受影响查询的转化率英国 +20%、法国 +34% |
| TOUS | 珠宝配饰 | 关键词加向量的混合检索 | 零结果页减少 87%,语义查询点击率 +27%,搜索带来的浏览商品数 +11% |
| DiDi Food | 拉美外卖平台 | 向量库补充原有引擎 | 无结果查询减少 19%,加购转化 +4%,15% 的查询走向量通道 |
| 某 200 万 SKU 平台 | 多品类电商 | 稠密向量语义检索 | 零相关结果从 38% 降到 4%,客单价 +22% |
| 某美国零售商 | 900 万商品 | 检索增强生成加重排 | 零结果从 30% 降到 9%,点击率 +1.6 个百分点,实验组 GMV +6.3% |
| Instacart | 生鲜电商 | 大模型做查询改写 | 长尾查询召回 +70 个百分点,精度 +18 个百分点 |
| Baymard 基准库 | 344 个大型电商站 | 人工 UX 评测 | 56% 的站点在查询类型处理上存在明显问题 |
这张表该怎么读
前六行是项目方自己公布的结果,最后一行是独立评测机构的基线。前者说明上限在哪,后者说明大多站点离那条线有多远。
表里最值得抄的一条来自 Instacart。他们没有先换引擎,而是先解决查询改写,把「牛油果油」自动扩展成替代品、上位品类、同义说法三类。召回提升 70 个百分点,靠的是让系统听懂人话,不是靠算得更快。
一次搜索失败会被 AI 算两次
站内搜索和站外 AI 引擎看起来是两件事。它们用的是同一套理解能力,读的也是同一批产品数据。站内读不懂的东西,外面那批爬虫同样读不懂。
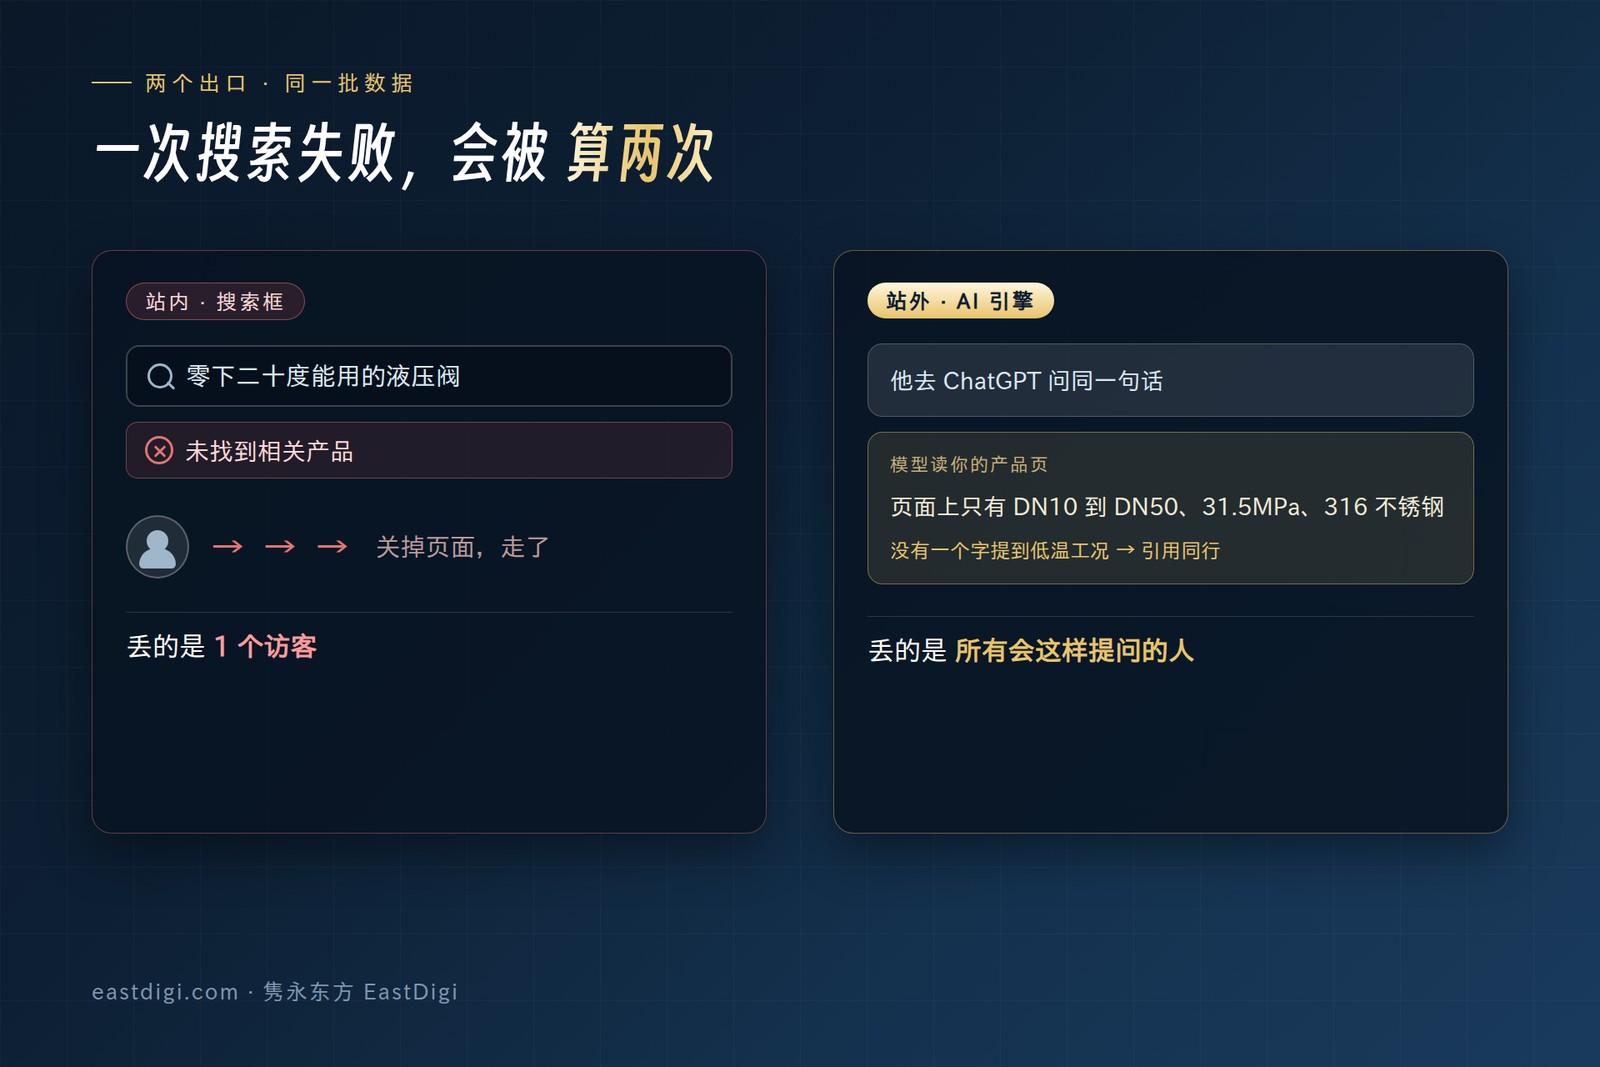
站内丢一个访客 站外丢一批
一个采购经理在站内搜「零下二十度能用的液压阀」,零结果,他走了,这是一个人的损失。
他去 ChatGPT 问同一句话,模型抓的是你的产品页。页面上只有 DN10 到 DN50、31.5MPa、壳体材质 316 不锈钢,没有一个字提到低温工况,模型拼不出答案,于是引用了另一家写了工况说明的同行。这一次丢掉的是所有会这样提问的人。
语义层建一次 两个出口共用
产品库向量化之后,站内搜索用的是它,外部 AI 抓取时理解的也是它。同一份「这条产品适合什么工况」的描述,在站内是一段答案,在站外是一段可被引用的实体说明。
这也是为什么把这件事当成前台功能升级来做,通常做不出效果。它改的是数据层的表达方式。
向量化抹平的是可理解度差距
大平台的优势一直是 SKU 数量和多语言同义词库。这两样东西都要人力和时间堆,中小制造企业短期追不上。向量检索把竞争点换了一个位置。
数量优势在语义面前会打折
关键词检索的召回靠词表覆盖,谁的词表厚谁赢。语义检索的召回靠含义距离,一条写得清楚的产品记录,能和几十种不同说法匹配上,不需要为每一种说法单独维护词条。
这就把「有多少条同义词」的问题,换成了「每条产品写得多清楚」的问题。
工况知识是最稀缺的语料
一家做了十几年的阀门厂,工程师知道自己的产品在什么介质下会结垢、在哪个温度段密封件先失效、客户把背压算错时会出现什么现象。这些内容在任何平台上都搜不到,因为只有做过的人写得出来。
把它写进产品页,语义检索就有了别人没有的锚点。大平台有流量,写不出这种细节。
三个可以自己验证的杠杆
下面三条按投入从低到高排。每一条都能在一个月内看到变化,也都能用站内数据验证,不用等外部 AI 的反馈。
杠杆一 字段细到能回答问题
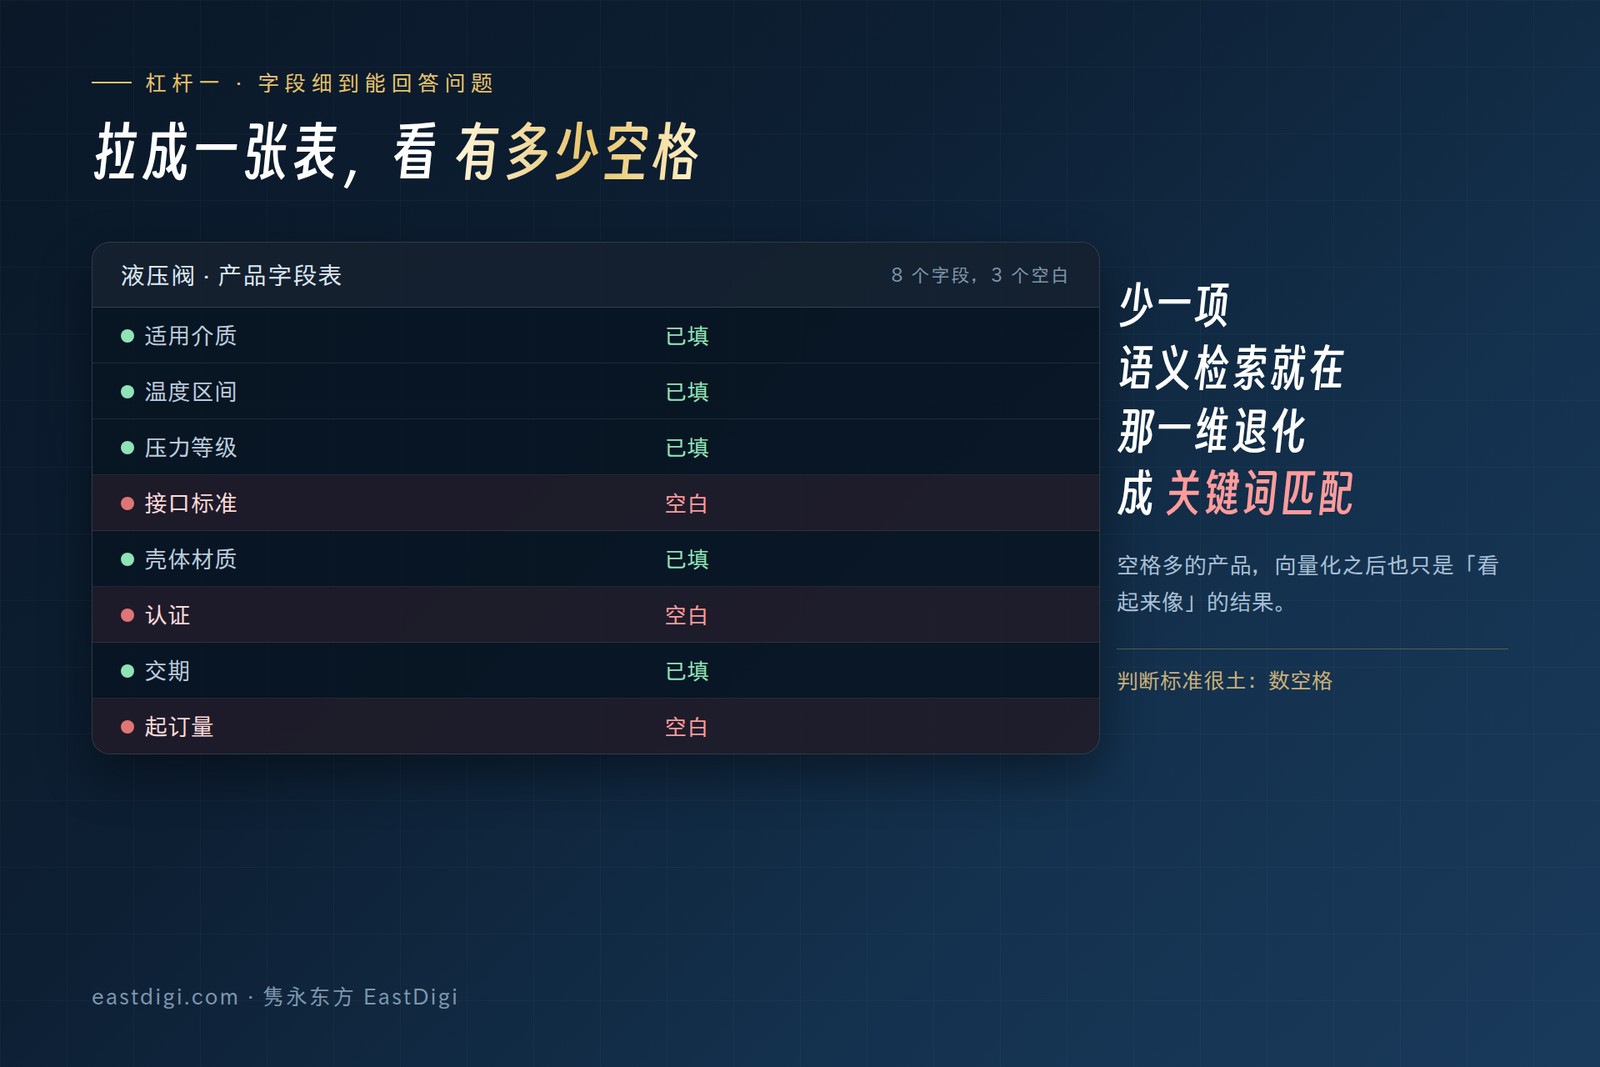
一条产品记录要能回答采购经理真正会问的那几件事,适用介质、温度区间、压力等级、接口标准、壳体材质、认证、交期、起订量。少一项,语义检索在那一维上就退化成关键词匹配。
判断标准很土,把字段拉成一张表,看有多少空格。空格多的产品,向量化之后也只是「看起来像」的结果。
杠杆二 查询改写覆盖单位与俗称
同一个东西,工程师写 DN50,采购写两寸,德国客户写 DN 50 PN16,中东客户直接把材质写成 SS316。温度也一样,零下二十度和 minus 20 是同一件事。
这一层不做,向量模型只能猜。Instacart 那 70 个百分点的召回提升,全部来自把这一步做扎实。
杠杆三 结果页先给答案再给清单
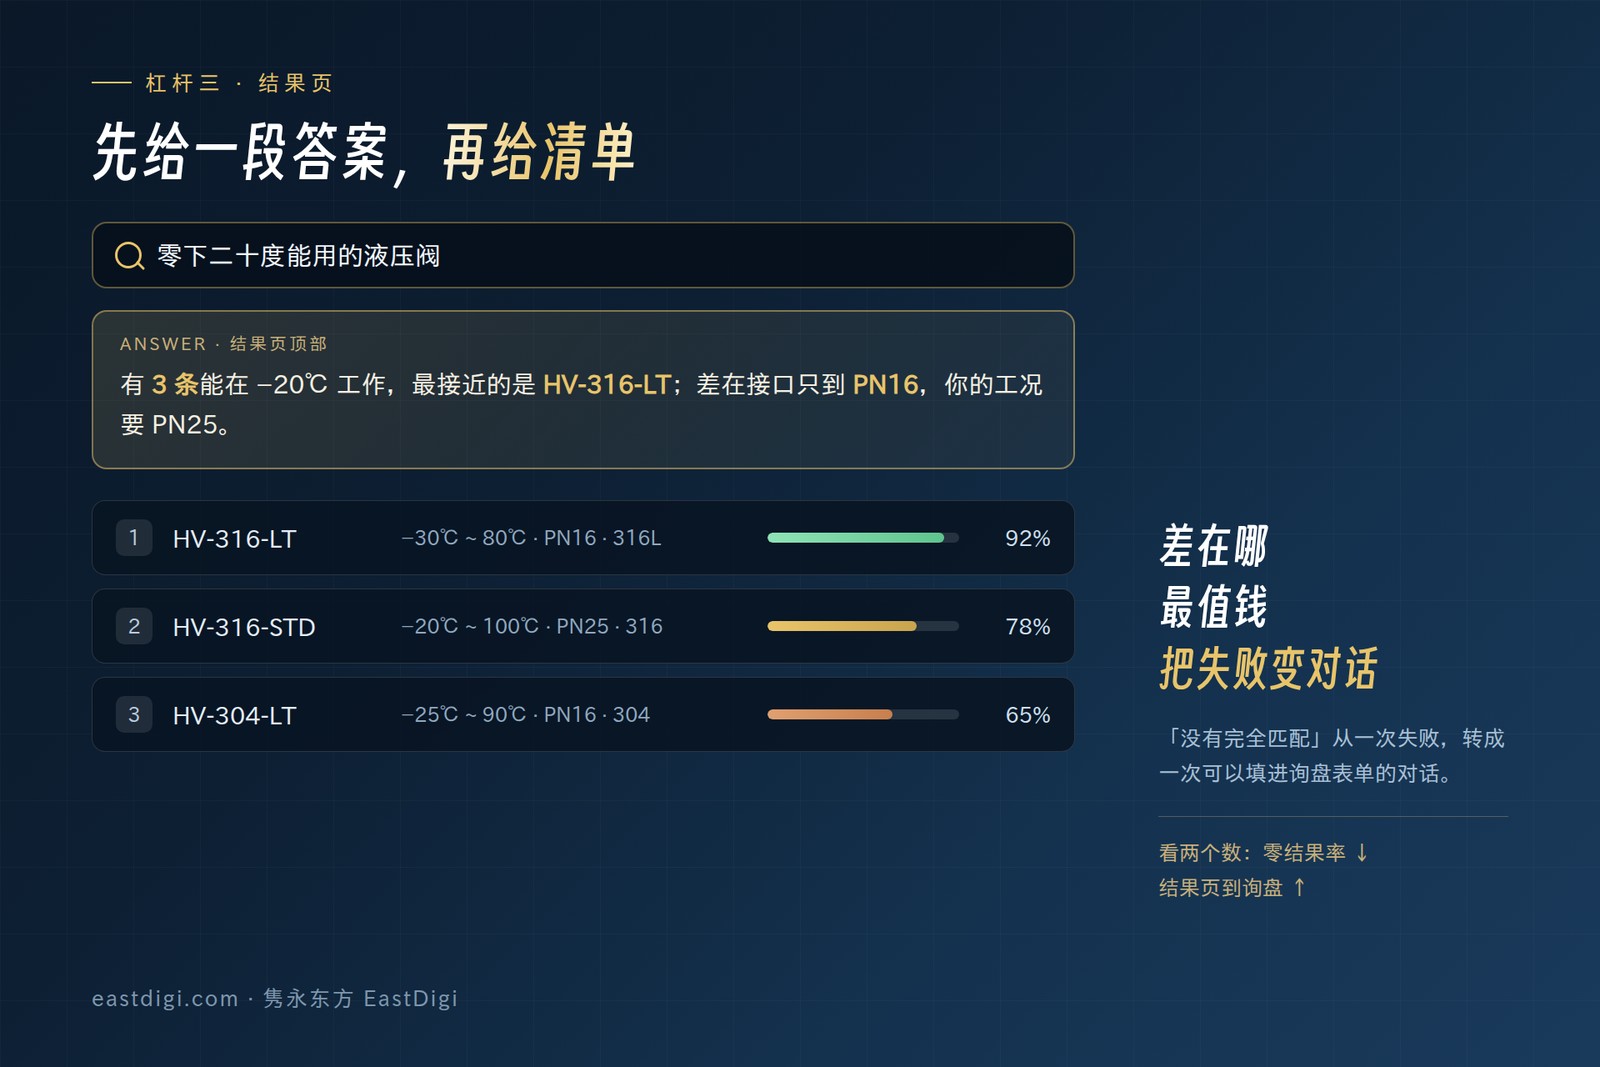
传统结果页给二十个产品卡片,让用户自己判断哪个合适。语义检索有能力先给一段话,说明为什么这几条匹配、哪一条最接近、差在哪。
差在哪这句话最值钱。它把「没有完全匹配」从一次失败,转成一次可以填进询盘表单的对话。衡量指标也随之变化,除了零结果率,还要看结果页到询盘的转化,和答案被展开的比例。
隽永东方的处理顺序 数据层先于展示层
我们给制造企业做独立站,通常把这件事排在视觉改版之前。原因很实际,语义层的产出会反过来决定页面该有什么模块。
先做能回答的字段 再做好看的页面
第一步是把散落在图纸、选型手册、老工程师脑子里的参数收成结构化字段,第二步才是页面怎么排。反过来做,页面会先定型,字段永远补不进去。
这套顺序在我们做产品页优化时已经跑过很多轮,语义检索只是把同一批字段再用一次。
和外部 GEO 的关系
站内语义层建好之后,外部 AI 爬虫读到的产品数据也同步变清楚。这件事和放行 AI 爬虫、补齐实体信息属于同一套工程,不需要另开一个项目。
重复劳动的部分我们交给 Hermes 引擎跑,人负责判断哪条工况描述值得写下来。
从哪一步开始动手
不必等预算。这件事可以先从一个产品线试,跑通了再铺开,改动范围也能控制住。
这周可以做的两件事
一是把站内搜索日志导出来,看最近三个月的零结果查询,按出现次数排序,前五十条就是客户的原话。二是挑一条主力产品线,把它的字段表拉出来,数空格。
这两件事做完,问题有多大、值不值得改,基本就有答案了。
一个月内应该看到的变化
零结果率往下走是第一层。第二层是搜索结果页的停留时间变长,说明答案被读了。第三层是询盘表单里出现更具体的工况描述,那批人是从搜索框进来的。
三个月还看不到第一层变化,通常要回头查字段表,换几次模型也是同一个结果。
方便的话加我微信:15821651082。把你站内的零结果查询发我几条,我看看是哪一层的词对不上。也可以先读一遍GA4 数据体系那篇,把搜索行为先量出来,再决定改造顺序。